Analýza dat
Základní analýza
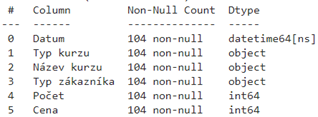
Sekce “Základní analýza”Uvažujme proměnnou s názvem df, ve které budou uloženy data z Excelu se sloupci datum, typ kurzu, název kurzu, typ zákazníka, počet a cena, na kterých se bude provádět výběr dat. Základní charakteristika dat je následující:
df = xl(„A1:F105“, headers=True)
df.info()
Sum
Sekce “Sum”Definice
Sekce “Definice”Vypočítá součet hodnot podle sloupců nebo řádků.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Funkce suma funguje pouze na číselné hodnoty. Pokud tedy je nutné sečíst celý dataframe, je nutné, aby v každé buňce byly číselné hodnoty, jinak je nutné sčítat pouze specifický sloupec.
Argumenty
Sekce “Argumenty”axis (int, výchozí=0):
- 0 (default): Součet hodnot v jednotlivých sloupcích.
- 1: Součet hodnot v jednotlivých řádcích.
skipna (bool, výchozí=True) – Pokud True, ignoruje prázdné buňky.
min_count (int, výchozí=0) – Požadovaný minimální počet hodnot pro provedení operace. Pokud je v dataframe méně nenulových hodnot než stanovený „min_count“, výstupem bude NA.
Použití
Sekce “Použití”df.sum() – výpočet sumy po jednotlivých sloupcích pro celý dataframe. Výsledek pak bude pro každý sloupec sečtené hodnoty v daném sloupci. Pokud nejsou všechny sloupce číselné nebo bool, výsledkem bude error.
df[‚Cena‘].sum() – Suma pro specifický sloupec (cena).
df[[‚Cena‘, ‚Počet‘]].sum() – Suma pro sloupec „Cena“ a sloupec „Počet“. Pro každý sloupec zvlášť.
df[‚Cena‘].sum(min_count=1000) – Pokud je méně hodnot pro sečtení než 1000, výsledkem bude „nan“:
Použití s ostatními funkcemi
Sekce “Použití s ostatními funkcemi”df[[‚Cena‘, ‚Počet‘]].to_numpy().sum() – Vypočte jeden součet na základě více sloupců.
Mean
Sekce “Mean”Definice
Sekce “Definice”Vypočítá průměr hodnot podle sloupců nebo řádků.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Funkce průměr funguje pouze na číselné hodnoty. Pokud tedy je nutné průměrovat celý dataframe, musí v každé buňce být číselné hodnoty, jinak je potřeba průměrovat pouze specifický sloupec.
Argumenty
Sekce “Argumenty”axis (int, výchozí=0):
- 0 (výchozí) – Průměr hodnot v jednotlivých sloupcích.
- 1 – Průměr hodnot v jednotlivých řádcích.
skipna (bool, výchozí=True) – Pokud True, ignoruje prázdné buňky.
Použití
Sekce “Použití”df.mean() – výpočet průměru po jednotlivých sloupcích pro celý dataframe. Výsledek pak bude pro každý sloupec zprůměrované hodnoty v daném sloupci. Pokud nejsou všechny sloupce číselné nebo bool, výsledkem bude error.
df[‚Cena‘].mean() – Průměr pro specifický sloupec (cena).
df[[‚Cena‘, ‚Počet‘]].mean() – Průměr pro sloupec „Cena“ a sloupec „Počet“. Pro každý sloupec zvlášť.
Použití s ostatními funkcemi
Sekce “Použití s ostatními funkcemi”df[[‚Cena‘, ‚Počet‘]].to_numpy().mean() – Vypočte jeden průměr na základě více sloupců.
Median
Sekce “Median”Definice
Sekce “Definice”Vypočítá medián hodnot podle sloupců nebo řádků.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Funkce median funguje pouze na číselné hodnoty. Pokud tedy je nutné zjistit medián na celý dataframe, musí v každé buňce být číselné hodnoty, jinak je potřeba zjistit medián pouze pro specifický sloupec.
Argumenty
Sekce “Argumenty”axis (int, výchozí=0):
- 0 (výchozí) – Medián hodnot v jednotlivých sloupcích.
- 1 – Medián hodnot v jednotlivých řádcích.
skipna (bool, výchozí=True) – Pokud True, ignoruje prázdné buňky.
Použití
Sekce “Použití”df.median() – výpočet mediánu po jednotlivých sloupcích pro celý dataframe. Výsledek pak bude pro každý sloupec medián v daném sloupci. Pokud nejsou všechny sloupce číselné nebo bool, výsledkem bude error.
df[‚Cena‘].median() – Medián pro specifický sloupec (cena).
df[[‚Cena‘, ‚Počet‘]].median() – Medián pro sloupec „Cena“ a sloupec „Počet“. Pro každý sloupec zvlášť.
Min
Sekce “Min”Definice
Sekce “Definice”Vypočítá minimální hodnotu v daném sloupci nebo řádku.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Funkce min funguje i na textové sloupce, nicméně výstup z textových sloupců nedává smysl.
Argumenty
Sekce “Argumenty”axis (int, výchozí=0):
- 0 (výchozí) – Minimální hodnota v jednotlivých sloupcích.
- 1 – Minimální hodnota v jednotlivých řádcích.
skipna (bool, výchozí=True) – Pokud True, ignoruje prázdné buňky.
Použití
Sekce “Použití”df.min() – výpočet minimální hodnoty po jednotlivých sloupcích pro celý dataframe. Výsledek pak bude pro každý sloupec minimum v daném sloupci. Pokud se jedná o textové sloupce, funkce vrátí výsledek, ale nebude mít vypovídající hodnotu.
df[‚Cena‘].min() – Minimum pro specifický sloupec (cena).
df[[‚Cena‘, ‚Počet‘]].min() – Minimum pro sloupec „Cena“ a sloupec „Počet“. Pro každý sloupec zvlášť.
Použití s ostatními funkcemi
Sekce “Použití s ostatními funkcemi”df[[‚Cena‘, ‚Počet‘]].to_numpy().min() – Vypočte jedno minimum na základě více sloupců.
Max
Sekce “Max”Definice
Sekce “Definice”Vypočítá maximální hodnotu v daném sloupci nebo řádku.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Funkce max funguje i na textové sloupce, nicméně výstup z textových sloupců nedává smysl.
Argumenty
Sekce “Argumenty”axis (int, výchozí=0):
- 0 (výchozí) – Maximální hodnota v jednotlivých sloupcích.
- 1 – Maximální hodnota v jednotlivých řádcích.
skipna (bool, výchozí=True) – Pokud True, ignoruje prázdné buňky.
Použití
Sekce “Použití”df.max() – výpočet maximální hodnoty po jednotlivých sloupcích pro celý dataframe. Výsledek pak bude pro každý sloupec maximum v daném sloupci. Pokud se jedná o textové sloupce, funkce vrátí výsledek, ale nebude mít vypovídající hodnotu.
df[‚Cena‘].max() – Maximum pro specifický sloupec (cena).
df[[‚Cena‘, ‚Počet‘]].max() – Maximum pro sloupec „Cena“ a sloupec „Počet“. Pro každý sloupec zvlášť.
Použití s ostatními funkcemi
Sekce “Použití s ostatními funkcemi”df[[‚Cena‘, ‚Počet‘]].to_numpy().max() – Vypočte jedno maximum na základě více sloupců.
Count
Sekce “Count”Definice
Sekce “Definice”Vrátí počet neprázdných (nenačítá NaN) hodnot podle sloupců nebo řádků.
Argumenty
Sekce “Argumenty”axis (int, výchozí=0):
- 0 (výchozí) – Maximální hodnota v jednotlivých sloupcích.
- 1 – Maximální hodnota v jednotlivých řádcích.
Použití
Sekce “Použití”df.count() – Počet neprázdných hodnot pro každý sloupec v dataframe.
df[‚Cena‘].count() – Počet vyplněných hodnot ve specifickém sloupci.
df[[‚Cena‘, ‚Počet‘]].count() – Počet nenulových hodnot pro více specifických sloupců z dataframe.
Skupinová analýza
Sekce “Skupinová analýza”Groupby
Sekce “Groupby”Definice
Sekce “Definice”Provádí skupinové seskupení podle hodnot ve specifikovaném sloupci nebo sloupcích.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Funkce lze použít i na seskupení dle více sloupců. Pokud se např. seskupují data dle 2 sloupců, budou 2 seskupující sloupce i ve výstupu a k tomu sloupec s danou číselnou agregací. Je možné nastavit i více agregací, než pouze jednu. Funkce se chová podobně jako klasická kontingenční tabulka. Za funkci groupby se obvykle dává jedna z matematických funkcí jako sum, mean, count a další. Existuje funkce pivot_table, která přímo vytvoří kontingenční tabulku z dat. Výstup je pro většinu nastavení stejný jako funkce groupby.
Argumenty
Sekce “Argumenty”by (mapping, function, label, nebo list of labels) – Určuje, podle jakého sloupce se seskupují data.
axis (int, výchozí=0) – Seskupení podle řádků (0) nebo sloupců (1).
level (int, label, nebo list, volitelný) – Seskupení na konkrétní úrovni indexu (pro víceúrovňové indexy).
as_index (bool, výchozí=True) – Vrátí object se skupinami jako index.
Dropna (bool, výchozí=True) – Odstraní prázdné buňky ze seskupení. Pokud „False“, prázdné buňky budou v seskupení.
Použití
Sekce “Použití”df.groupby(‚Typ kurzu‘)[‚Cena‘].mean() – Seskupení dle kategorií v sloupci „Typ kurzu“ a následně průměr funkcí mean dle sloupce „Cena“ pro každou kategorii.
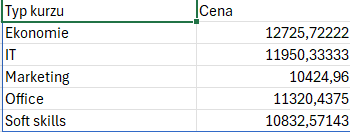
df.groupby(‚Typ kurzu‘)[‚Počet‘].sum() – Seskupení dle kategorií v sloupci „Typ kurzu“ a funkce sumy (sum) sloupce „Počet“ pro jednotlivé kategorie.
df.groupby(‚Typ kurzu‘).count() – Počet vyplněných buněk v sloupci „Typ kurzu“ dle jednotlivých kategorií kurzu pomocí funkce count.
df.groupby([‚Typ kurzu‘, ‚Název kurzu‘])[‚Cena‘].sum() – Seskupení podle 2 sloupců (Název kurzu a Typ kurzu). Seskupení je provedeno na sloupci „Cena“ a je pro něj vrácena suma pro jednotlivé Názvy kurzu a Typ kurzu.
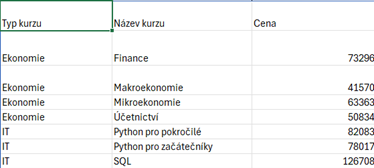
df.groupby(‚Typ kurzu‘)[‚Cena‘].agg([‚sum‘, ‚mean‘]) – Seskupení pouze dle sloupce „Typ kurzu“. Agregační funkce jsou 2 a to suma a průměr, které musí být vloženy do listu funkce agg. Obě agregační funkce provádějí výpočet pro sloupec „Cena“.
df.groupby([‚Typ kurzu‘, ‚Název kurzu‘])[‚Cena‘].agg([‚sum‘, ‚mean‘]) – Více sloupců, dle kterých se mají data seskupit (Typ kurzu a Název kurzu) a více agregačních funkcí (sum a mean). Agregační funkce provádí výpočet pro sloupec „Cena“.
Pivot_table
Sekce “Pivot_table”Definice
Sekce “Definice”Vytvoří kontingenční tabulku z vybraných dat.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Do jednotlivých argumentů lze vkládat více sloupců resp. řádků, dle kterých mají být data agregovány na specifické matematické nebo statistické funkci. Pokud je potřebné data seskupit dle více sloupců nebo řádků, musí být v argumentu tyto názvy sloupců resp. řádků vložený do listu. Výstup je při většině nastavení stejný jako u funkce groupby. Je tedy možné použít jednu z těchto funkcí pro seskupení dat.
Argumenty
Sekce “Argumenty”values (str, volitelný) – Sloupec, jehož hodnoty budou použity pro agregaci v kontingenční tabulce.
index (str nebo list, volitelný) – Sloupce, které se stanou řádky kontingenční tabulky.
columns (str nebo list, volitelný) – Sloupce, které se stanou sloupci kontingenční tabulky.
aggfunc (function, výchozí=‚mean‘) – Funkce pro agregaci (také např. sum, count).
Další argumenty:
Fill_value (scalar, výchozí=None) – Hodnoty, které mají nahradit prázdné buňky v případě, že jsou v datech.
Margins (bool, výchozí=False) – Pokud je nastaveno na True, speciální ‚all‘ sloupce a řádky budou přidány s částečnými agregacemi skupin napříč kategoriemi na řádcích a sloupcích.
dropNA (bool, výchozí=True) – Pokud jsou v datech prázdné buňky, nezahrnují se do defaultně do výpočtu. Pokud je potřebné zahrnout do výpočtu, argument musí být nastaven na „False“. Zároveň je následně možné kombinovat s argumentem fill_value.
Margin_name (str, výchozí=‘All‘) – Název řádku/slupce, který bude obsahovat celkové hodnoty v případě, že argument margins je nastaven na True.
Použití
Sekce “Použití”df.pivot_table(values=’Cena‘, index=’Typ kurzu‘, aggfunc=’mean‘) – Průměr pro sloupec „Cena“ dle jednotlivých typů kurzu, které jsou v řádcích.
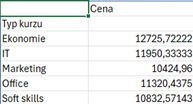
df.pivot_table(values=’Cena‘, columns=’Typ kurzu‘, aggfunc=’mean‘) – Průměr pro sloupec „Cena“ dle jednotlivých typů kurzu, které jsou v sloupcích.

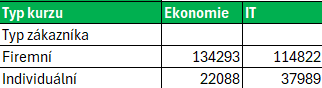
df.pivot_table(values=’Cena‘, index=’Typ zákazníka‘, columns=’Typ kurzu‘, aggfunc=’sum‘) – Suma pro sloupec „Cena“, kde v řádcích je sloupec „Typ zákazníka“ a v sloupcích „Typ kurzu“.
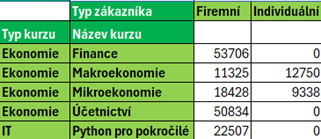
df.pivot_table(values=’Cena‘, index=[‚Typ kurzu‘, ‚Název kurzu‘], columns=’Typ zákazníka‘, aggfunc=’sum‘) – Suma pro sloupec „Cena“ pro více sloupců v řádcích pivotky (Typ kurzu & Název kurzu) s jedním sloupcem ve sloupcích (Typ zákazníka) s prázdnými hodnotami, pokud pro danou skupinu agregace nejsou data.
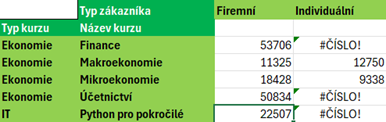
df.pivot_table(values=’Cena‘, index=[‚Typ kurzu‘, ‚Název kurzu‘], columns=’Typ zákazníka‘, aggfunc=’sum‘, fill_value=0) – Stejný příklad jako předešlý, s rozdílem, že prázdné hodnoty jsou vyplněny nulou.
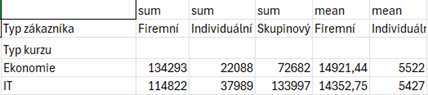
df.pivot_table(values=’Cena‘, index=’Typ kurzu‘, columns=’Typ zákazníka‘, aggfunc=[‚sum‘, ‚mean‘]) – Více agregovaných funkcí do pivotky (suma a průměr).
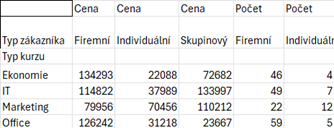
df.pivot_table(values=[‚Cena‘, ‚Počet‘], index=’Typ kurzu‘, columns=’Typ zákazníka‘, aggfunc=’sum‘) – Více sloupců v hodnotách (Cena & Počet) pro agregovanou funkci sumy.
Statistika
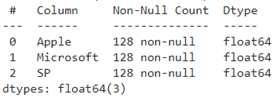
Sekce “Statistika”Uvažujme proměnnou s názvem df, ve které budou uloženy data z Excelu se sloupci „Apple“, „Microsoft“ a „SP“ pro hodnoty akcií v určitém rozmezí. Základní charakteristika dat je následující:
df = xl(„A1:F105“, headers=True)
df.info()
df.cov()
Sekce “df.cov()”Definice
Sekce “Definice”Vypočítá matici kovariance mezi numerickými sloupci.
Praktické vysvětlení
Sekce “Praktické vysvětlení”V dataframe musí být data, která jsou číselná (float, int…), popř. je nutné pro kovariance ze dataframe vybrat pouze sloupce, které jsou číselné výpočet kovariance. Pro textové sloupce není možné zjistit kovarianci dat. Kovariance je statistická míra určující, jak dvě proměnné mění své hodnoty společně. Jedná se o způsob, jak měřit sílu a směr vztahu mezi dvěma proměnnými. Více vypovídající je funkce corr. Výstupem kovariance v pythonu je dataframe, kde každý sloupec se porovnává s každým, tedy bude stejný počet řádků a sloupců ve výstupném dataframu.
Argumenty
Sekce “Argumenty”min_periods (int, volitelný) – Minimální počet vyplněných buněk (neprázdných hodnot) potřebný k výpočtu.
ddof (int, výchozí=1) – Delta stupňů volnosti. Dělitel používaný ve výpočtu je N- ddof, kde N představuje počet prvků (buněk). Tento argument lze použít pouze v případě, kdy v datech není žádná prázdná buňka.
numeric_only (bool, výchozí=False) – Zda zahrnovat pouze datové typy float, int nebo bool v datech.
Použití
Sekce “Použití”df.cov() – Matice kovariance
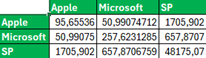
df.cov(min_periods=1000) – Kovarianční matice, kde musí být minimálně 1 000 hodnot.
Corr
Sekce “Corr”Definice
Sekce “Definice”Vypočítá korelační matice mezi numerickými sloupci.
Praktické vysvětlení
Sekce “Praktické vysvětlení”V dataframe musí být data, která jsou číselná (float, int…), jelikož výchozí metodou pro korelaci v této funkci je Pearsonova korelace. Je nutné pro korelaci z dataframe vybrat pouze sloupce, které jsou číselné, jelikož pro textové sloupce není možné počítat korelaci.
Korelace určuje sílu a směr lineárního vztahu mezi dvěma proměnnými. Na rozdíl od kovariance, korelace je normalizovaná hodnota, což znamená, že se vždy pohybuje v rozmezí -1 až 1.
Pokud je hodnota menší než 0 znamená, že když jedna proměnná roste, druhá proměnné klesá. Pokud je hodnota korelace větší než 0, když jedna proměnná roste, druhá proměnná také roste. Nulová korelace znamená, že mezi proměnnými neexistuje lineární vztah. Obecně čím vyšší je číslo korelace, tím silnější je lineární závislost. Čím nižší koeficient je, tím je nižší lineární závislost.
Korelace využívá výpočtu kovariance, pro kterou existuje funkce cov, nicméně není nutné ji volat pro výpočet korelace. Výstupem korelace v pythonu je dataframe, kde každý sloupec se porovnává s každým, tedy bude stejný počet řádků a sloupců ve výstupném dataframu. Na diagonále bude vždy 1, jelikož stejný sloupec porovnávaný se stejným sloupcem je vždy dokonalá lineární závislost. Vypovídající jsou ale data mimo diagonálu.
Argumenty
Sekce “Argumenty”method (str, výchozí=’pearson‘): Typ korelace:
- ‚pearson‘ – Pearsonova korelace měří lineární vztah číselných sloupců.
- ‚kendall‘ – Kendallova tau měří sílu vztahu pomocí souhlasu a nesouhlasu páru hodnot. Je vhodné pro malé datové sady nebo při měření monotónnosti.
- ‚spearman‘ – Spearmanův korelační koeficient měří vztah mezi dvěma proměnnými pomocí jejich pořadí. Funguje pro ordinální data (hodnocení 1-5). Data nemusí být normálně rozložena.
min_periods (int, volitelný): Minimální počet ne-NaN hodnot potřebný k výpočtu.
Použití
Sekce “Použití”Df.corr() – Korelační koeficient pro sloupce.
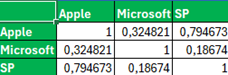
df.corr(method=’spearman‘) – Spermanova korelace.
Další analýzy
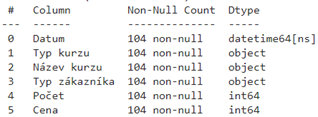
Sekce “Další analýzy”Uvažujme proměnnou s názvem df, ve které budou uloženy data z Excelu se sloupci datum, typ kurzu, název kurzu, typ zákazníka, počet a cena, na kterých se bude provádět výběr dat. Základní charakteristika dat je následující:
df = xl(„A1:F105“, headers=True)
df.info()
Value_counts
Sekce “Value_counts”Definice
Sekce “Definice”Vrátí počet výskytů jednotlivých hodnot ve sloupci.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Je nutné specifikovat sloupec, na který je nutné spočítat počet výskytů. Pokud je funkce použita na celý dataframe, tak je počítán počet stejných řádků v daném dataframu.
Argumenty
Sekce “Argumenty”Subset (label nebo list of labels, volitelný) – Sloupce, které mají být využity při počítání unikátních kombinací.
normalize (bool, výchozí=False) – Pokud True, vrátí relativní četnosti (procenta).
sort (bool, výchozí=True) – Řazení podle četnosti. Pokud stanoveno na „False“, řadí se dle sloupci v dataframe.
ascending (bool, výchozí=False) – Řazení vzestupně.
Dropna (bool, výchozí=True) – Nebude zahrnovat buňky, které jsou prázdné.
Použití
Sekce “Použití”df[‚Typ kurzu‘].value_counts() – Počet stejných hodnot v sloupci Typ kurzu.
df.value_counts(subset=’Typ kurzu‘) – Stejný výstup jako v předešlém příkladu. Sloupec je ale stanoven v argumentu „subset“.
df[[‚Typ zákazníka‘, ‚Počet‘]].value_counts() – Počet stejných hodnot na 2 sloupcích. Počítají se stejné hodnoty pouze pokud jsou v obou sloupcích stejné hodnoty.
df.value_counts(subset=’Typ kurzu‘, ascending=True) – Řazení dle počtu vzestupně.
Rolling
Sekce “Rolling”Definice
Sekce “Definice”Vypočítá klouzavý průměr/součet nebo jinou statistickou funkci přes n hodnot.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Klouzavý průměr vždy přestane počítat jednu horní hodnotu a přidá jednu spodní hodnotu. Jedná se tedy o „posuvně okno“ napříč daty. Statistická funkce musí být stanovena za funkcí rolling, tedy např. funkce sum, mean nebo další. Klouzavý průměr/součet se obvykle používá s časovými řadami (vývoj v letech, dnech, akcie atd.). Je také nutné mít nastavený správný index v dataframe.
Argumenty
Sekce “Argumenty”window (int, timedelta, str) – Velikost okna (počet hodnot).
min_periods (int, výchozí=None) – Minimální počet hodnot v okně potřebný k výpočtu.
center (bool, výchozí=False) – Pokud True, zarovná okno na střed daného indexu.
axis (int nebo str, výchozí=0) – Výpočet na základě řádků. Pokud 1, výpočet na základě sloupců.
step (int, výchozí=None) – Vypočítá okno každého kroku. Pokud je krok jiný než „None“ nebo 1, výstup bude menší než input, jelikož „posuvné okno“ bude vyšší.
Použití
Sekce “Použití”df[‚Apple‘].rolling(window=’7D‘).mean() – 7denní klouzavý průměr sloupce Apple.
df[‚Apple‘].rolling(window=’4D‘).sum() – 4denní klouzavý součet sloupce Apple.
Expanding
Sekce “Expanding”Definice
Sekce “Definice”Vypočítá kumulativní součet/průměr nebo jinou statistickou veličinu přes všechny předchozí hodnoty.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Za danou funkci expanding je nutné zadat statistickou funkci (např. sum, mean, median), dle které se mají data kumulativně sečíst, zprůměrovat…
Argumenty
Sekce “Argumenty”min_periods (int, default=1) – Minimální počet hodnot potřebný k výpočtu.
axis (int nebo str, výchozí=0) – Výpočet na základě řádků. Pokud 1, výpočet na základě sloupců.
Použití
Sekce “Použití”df[‚Apple‘].expanding(1).sum() – Kumulativní součet
df[‚Apple‘].expanding(1).mean() – kumulativní průměr
© 2026 Excelland